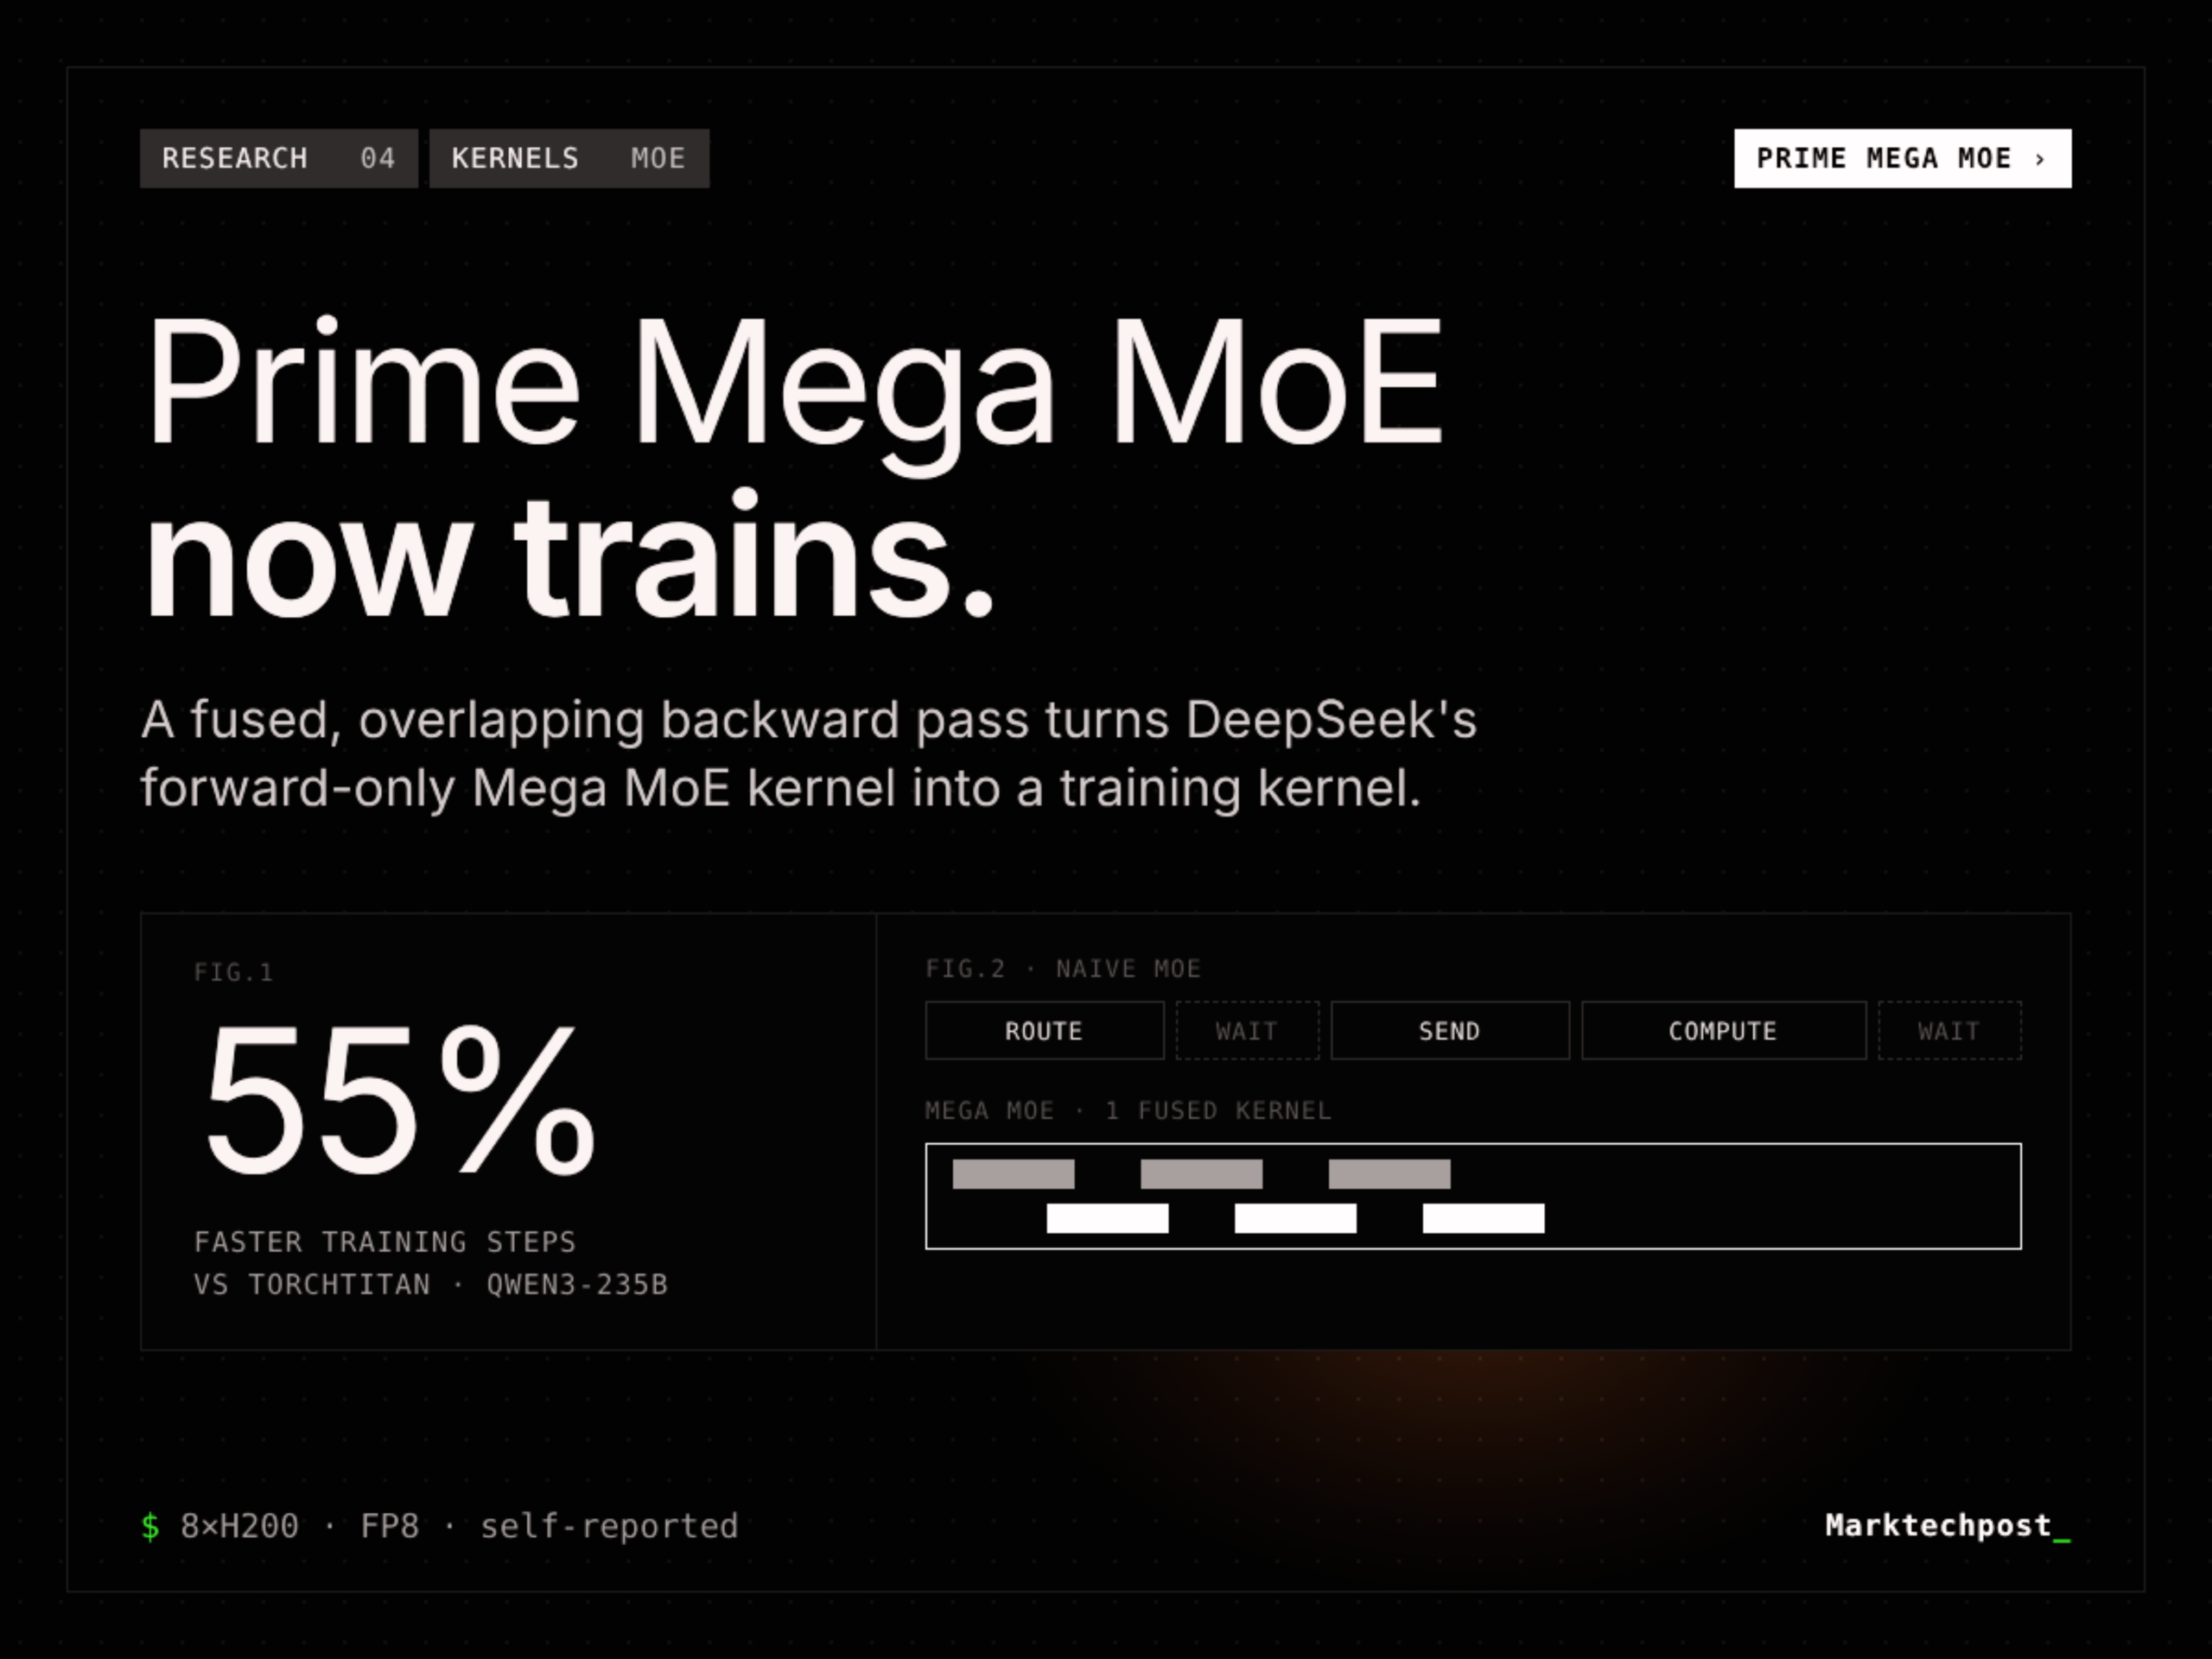
Prime Intellect Releases Prime Mega MoE: Trainable Fused MoE Kernel, 3.11x Faster Forward Pass
MarkTechPost
Read the full articlePrime Intellect launched Prime Mega MoE, a fused MoE kernel enabling faster training by overlapping forward and backward passes, boosting Qwen3 MoE model training speed by up to 55% over TorchTitan.